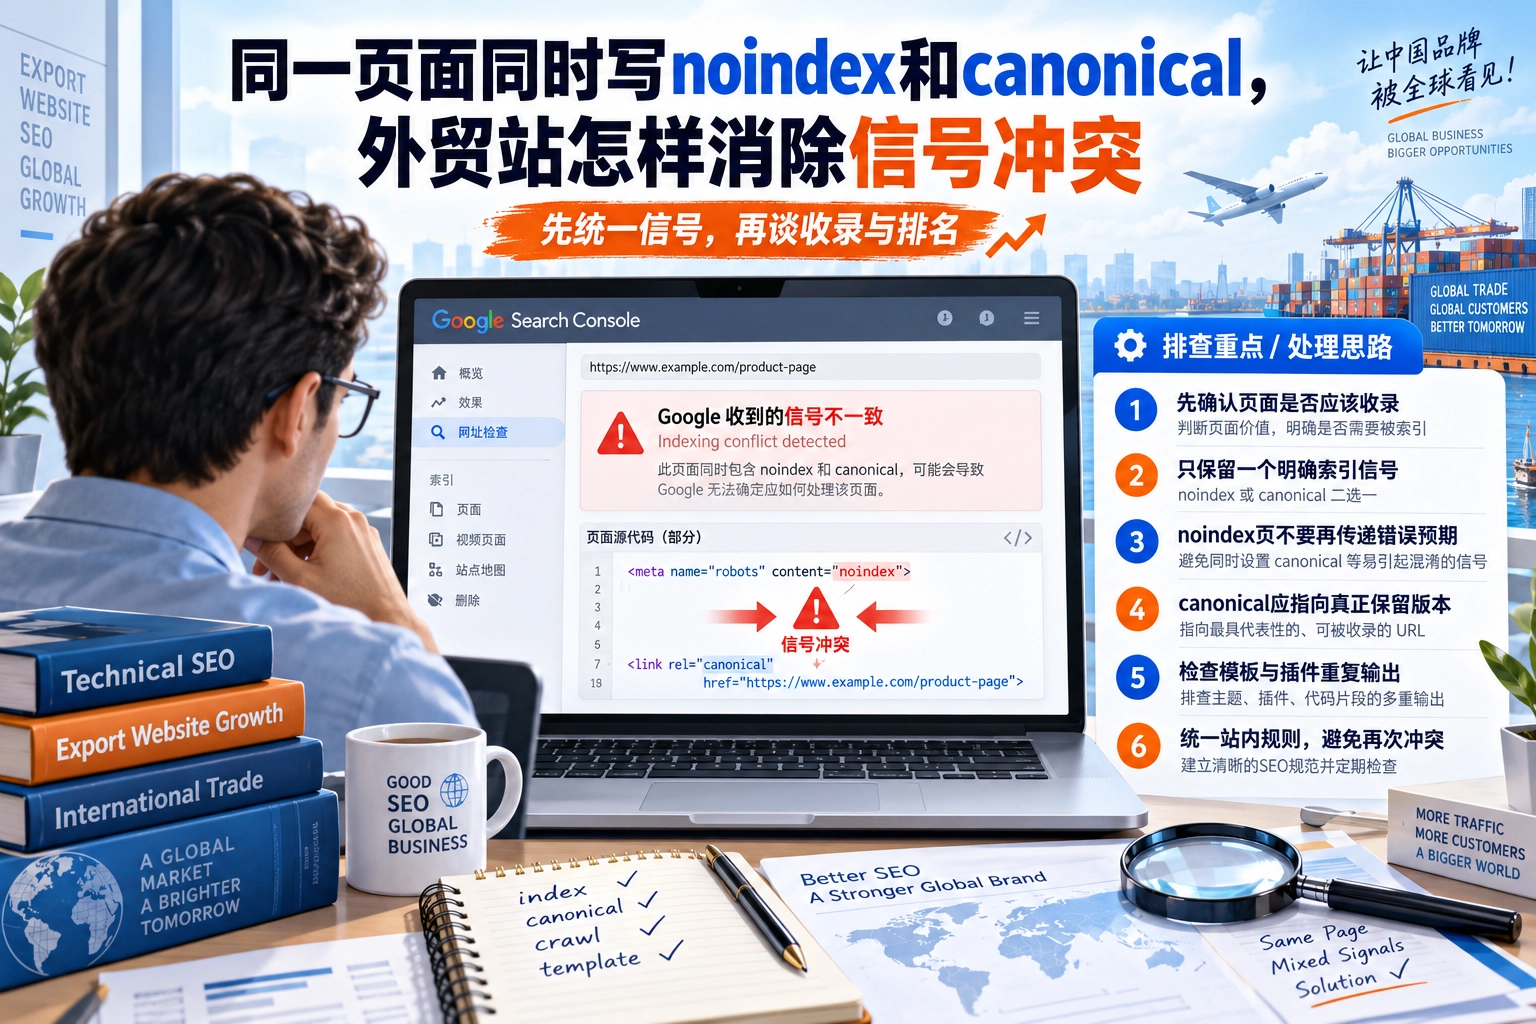
有些外贸站处理重复内容时,会同时添加noindex和canonical:编辑希望某页不要出现在搜索中,SEO插件却继续自动输出规范标签。后台看起来各项设置都有理由,实际页面究竟要保留、合并还是退出索引,却没有统一答案。
这两个设置出现在同一页,不必然构成语法错误。问题在于它们表达的目标是否符合企业预期,以及实际输出有没有来自不同位置的旧规则。不能看到两个名称就全部删除,也不能编出一个通用顺序,断言谷歌一定先处理哪一个。
排查应从页面用途开始。以下讨论的是公开页面的索引与规范化管理;涉及客户资料、内部报价或其他受限内容时,应使用真正的访问控制,不能把搜索标签当作保密措施。
1. 明确页面最终要达到的状态
先为待检查页面写一句清楚的目标,例如“保留这一产品页供买家搜索”“让重复版本以另一个页面为首选”“页面继续公开访问,但不希望出现在搜索结果中”。同一批网址可能有不同目标,不应仅因使用同一模板就全部套用相同规则。
目标还需要业务依据:保留页是否有独立产品信息,合并对象是否真实对应,退出索引是否会影响本来需要展示的公开资料。暂时缺少依据的页面先标记待确认,让产品、运营与开发共同核实。
| 页面目标 | 先确认的问题 | 修复后的验收重点 |
|---|---|---|
| 保留参与索引 | 页面是否有准确且独立的信息 | 误加限制已清理,主要内容与规范信号符合预期 |
| 规范化合并重复版本 | 源页与目标是否相同或高度相近 | 首选版本明确,链接与规范信息保持一致 |
| 退出搜索索引 | 是否仍需公开访问,是否含敏感内容 | 公开页的退出指令可读取;受限内容有访问保护 |
表格用于整理目标,不是搜索结果保证。允许索引不等于必定收录,声明规范页不等于强制选定它;退出索引也需要相应指令被获取和处理。把这些区别写清楚,后续才知道正在验收配置,还是观察搜索引擎处理结果。
2. 核对HTML与响应头中的规则
进入实际网址检查输出,不只看后台开关。先检查HTML里是否有robots或针对Googlebot的元标记,是否包含noindex,以及规范标签指向哪里。不同插件重复输出、测试环境配置遗留、模板继承等情况,都需要有具体页面证据才能确认。
接着检查HTTP响应头,特别是X-Robots-Tag。页面正文中看不到它,但服务器、CDN或其他配置仍可能在响应中添加索引规则。Google的robots元标记与X-Robots-Tag文档分别说明了这些设置方式及适用范围,排查时应同时记录。
如果规范信息也通过Link响应头提供,还要与HTML中的canonical核对目标。后台显示“允许索引”,但响应头仍输出noindex,说明当前页面与后台预期不一致;这时应追查具体配置来源,而不是继续给HTML追加另一条允许设置。
保存完整网址、检查时间、响应状态、规则内容及来源。涉及缓存或多层配置时,核对修改后实际请求得到的结果。Google文档关于robots规则冲突的说明,不能被扩展成canonical与noindex之间一套固定的强制处理次序。
3. 让重复页处理回到规范化问题
如果目标是让两份相同或高度相近内容明确首选版本,就先比较源页与目标页。具体产品的材料、接口或适用条件存在实质差异时,不能为减少网址数量把它们随意合并。页面是否重复,应以实际内容和采购任务为依据。
Google的规范化最佳实践不建议用noindex选择同一站点中的规范页面。noindex表达退出索引,不能用它来指挥谷歌把另一页选为规范版本,也不能承诺源页的搜索信号必然转到指定目标。
明确内容关系后,再选择适合页面用途的方式。重复版本仍需可访问时,可以评估规范标签;确实永久迁移、旧网址不再承担独立用途时,可以评估相应重定向。无论采用哪种方式,都应核对目标有效、内容对应,并同步整理主要内链与地图记录。
对于计划保留参与搜索的独立页面,应检查是否误加noindex,以及规范目标是否错误指向别处。对于确定退出索引的页面,则没有必要继续把“将它规范到另一页”当作主要验收目标。先清楚表达用途,再清理不必要或与预期矛盾的配置。
4. 确认退出索引页面仍可被读取
如果一页需要继续公开访问,但不希望出现在谷歌结果中,使用noindex时要确认谷歌能够抓取并读取指令。Google的noindex说明明确指出,robots.txt阻止抓取会妨碍谷歌读取页面上的索引限制。
因此,不能同时把页面挡在抓取之外,又认为它的noindex已经被读取。robots.txt管理的是抓取访问,单独禁止抓取并不保证网址不再出现在搜索中。应核对页面历史状态和实际规则,再安排相应处理与复查,避免把“已配置”写成“已退出”。
对于本来应公开的页面,若抓取被无意阻止,可以评估修正规则以便读取退出指令;对于必须保密的内容,应先落实登录鉴权和权限控制。不能为了让抓取工具读到noindex,先把受保护资料公开。公众仍能直接访问的文件,不会因为写了noindex就获得保密保护。
文件也要检查实际响应。有些企业只在网页模板里设置noindex,下载文件却由另一套服务提供;此时网页规则未必覆盖文件。是否需要文件级限制、由哪一层输出,应分别确认,不把一个后台开关视为整站所有资源都已处理。
5. 按目标状态逐项验收修复
为每个代表网址保存修复前后记录:页面目标、原规则、修改来源、当前响应、HTML标记、响应头及复查时间。共享模板还应包括正常页面作为对照,确认没有把本应保留的产品页一起排除。
技术验收先确认当前输出。保留页检查误加限制是否清理;合并页检查内容关系、规范目标和访问情况;公开退出页检查noindex是否实际输出且能被读取。受限资料单独验收访问权限,不能用能否被索引代替安全检查。
随后再观察搜索处理结果。根据网址检查工具说明区分实时测试与已处理信息,记录最新抓取时间。实时测试成功不代表已经收录,也不完整判断规范页选择;报告仍显示旧抓取状态时,不能据此宣布配置没有生效。
若后续结果仍偏离目标,应回查受影响页面与规则来源,而不是继续叠加标签。整个过程没有可通用于所有站点的处理天数,也不能保证某一标签组合带来排名提升。结束任务时,分别写明“当前输出已验证”和“索引结果已观察到”,未确认部分继续保留。
常见问题
noindex能用来选择规范页吗?
不宜将它作为规范化方法,应先确定重复内容的保留版本。Google不建议用noindex选择同站规范页;它用于退出索引,不是把另一页指定为唯一代表的工具。
robots屏蔽后还需要检查标签吗?
需要,屏蔽可能让谷歌无法读取页面上的退出索引指令。先区分页面是要停止抓取、退出索引,还是保护受限内容,再核对相应设置,不能把几个目标混在一起。
后台关闭索引就够了吗?
还需检查实际HTML与响应头,确认输出规则符合预期。插件、服务器和CDN可能分别产生设置;修改后要检查正式页面,并继续观察重新抓取后的状态。
下一步:给异常页面先写明目标
先选一批同时出现noindex与canonical的页面,逐条标注保留、合并或退出索引,再核对HTML和响应头。把没有确认用途的页面单列,避免在目标不清时全站批量删除或追加指令。
维森特可通过谷歌SEO诊断与推广服务,协助整理页面目标与技术输出差异。需要具体检查时,可通过咨询入口提供公开网址及现有设置记录,为运营与开发形成可执行的修复和验收清单。
参考资料
- Google Search Central:指定规范网址
- Google Search Central:使用noindex阻止索引
- Google Search Central:robots元标记与X-Robots-Tag
- Google Search Console:网址检查工具
延伸阅读
苏州维森特数字科技有限公司|外贸独立站建站、谷歌广告推广、谷歌SEO推广、Facebook推广。