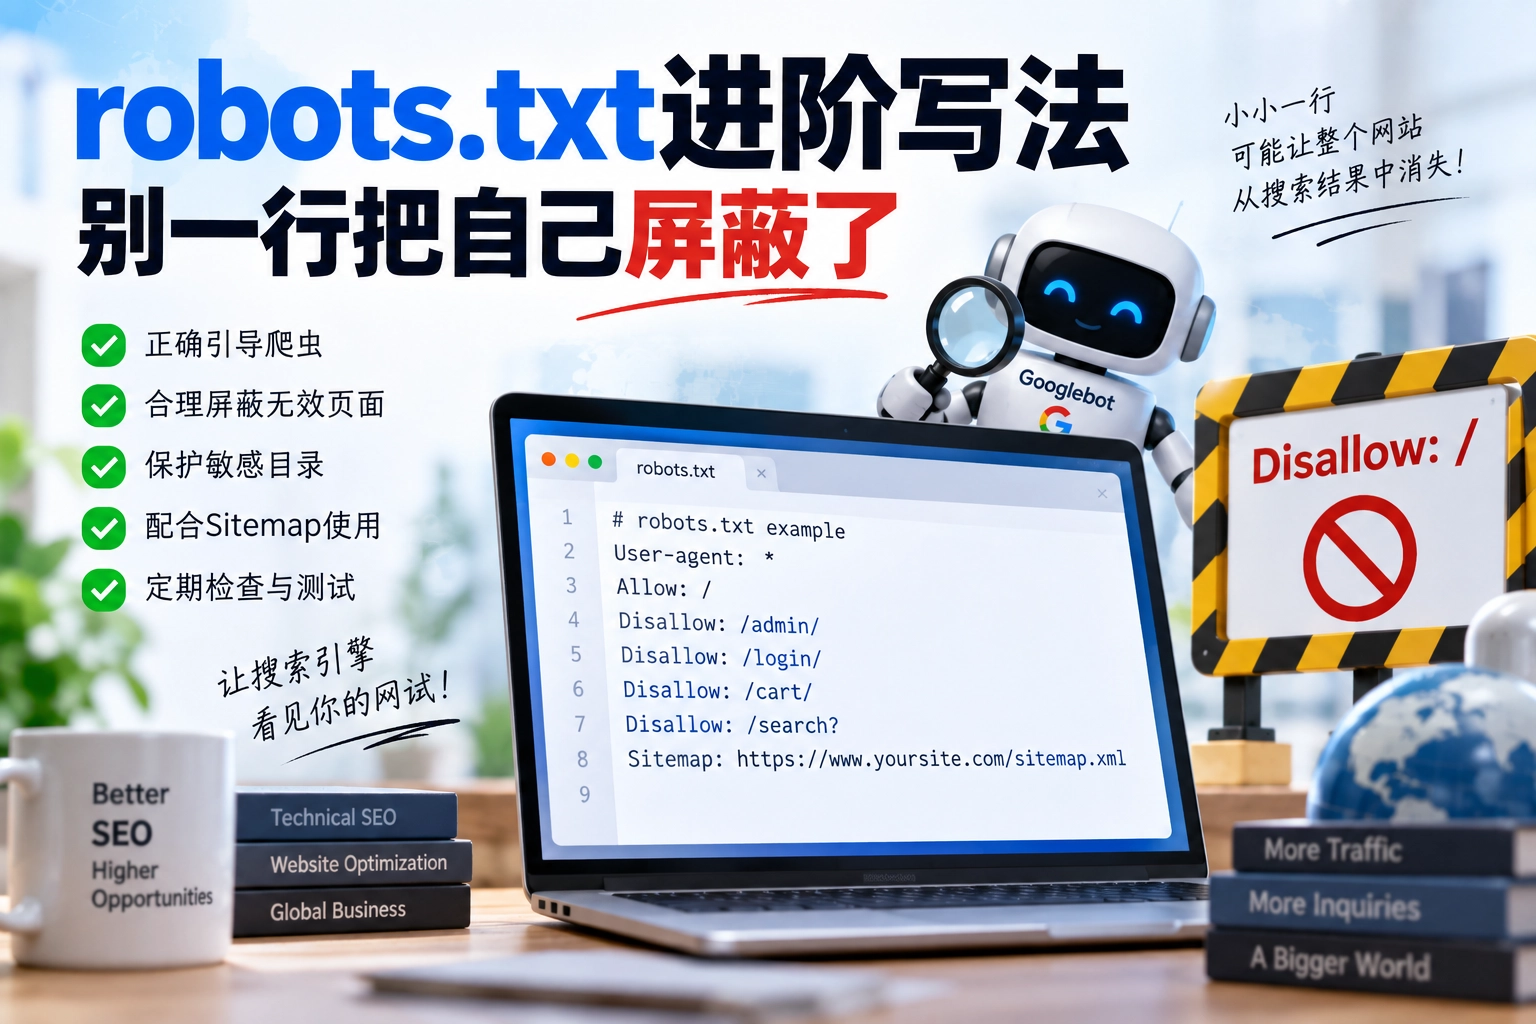
网站上所有文件里,robots.txt 大概是最短的那个——通常就十几行。也是出错代价最大的那个:一行写错,整站可以从搜索结果里消失。
更要命的是它出错以后一点动静都没有。不报错、不弹窗、页面照样打得开,你什么异常都看不到。等一两个月后发现流量断了,再回头查,往往已经过去一整个季度。
这篇把它的实际行为讲清楚:规则到底怎么判优先级、通配符怎么用、哪些是行业里反复出现的事故,以及它和 noindex 各管什么。规则依据全部来自谷歌官方文档。
一、规则优先级与匹配规则
多数人对 robots.txt 的误解,是以为规则从上到下依次生效。不是这样。
最具体的规则胜出
谷歌的规则是:按路径长度判断,最具体的规则生效;当规则冲突且具体程度相同时,采用限制最少的那条。
举谷歌文档里的例子:对于地址 `/page.htm`,同时存在 `allow: /page` 和 `disallow: /*.htm` 两条规则时,disallow 生效——因为 `/*.htm` 匹配到的路径更长,更具体。
这个机制很容易反直觉。很多人会以为写在前面的规则优先,或者以为 allow 天然优先于 disallow,两种理解都不对。
用户代理分组:只有一组生效
另一条同样重要:谷歌只使用最匹配的那一个用户代理分组,忽略其他所有分组。
所以如果你的文件里既有 `User-agent: *` 的规则,又有 `User-agent: Googlebot` 的规则,那么 Googlebot 只读后者,前者里的规则对它完全无效。
这是最常见的事故来源之一:给通用分组写了一堆细致的规则,又给 Googlebot 单独写了一条简单规则,结果通用分组的规则全部失效。
另外,像 `googlebot*` 或 `googlebot/1.2` 这类部分匹配会被规范化成 `googlebot`;如果多个分组都匹配同一个爬虫,它们的规则会被内部合并。
路径区分大小写
字段名(`allow`、`disallow`)不区分大小写,但路径值区分大小写。`Disallow: /Fish` 不会匹配 `/fish`。
这一条对使用了混合大小写 URL 的网站是个实际风险——写了规则却没生效,或者只挡住了一半。
文件大小上限
谷歌对 robots.txt 的处理上限是 500 KiB,超出部分会被忽略。正常网站不会碰到这个限制,但如果有人用脚本往里塞了几万行规则,后面的部分等于没写。
来源:Google 搜索中心 robots.txt 规范文档,链接见文末。其他搜索引擎的解析细节可能与谷歌不同。
二、通配符的正确用法
谷歌支持两个通配符:
- 星号 `*` 表示零个或多个任意有效字符
- 美元符号 `$` 表示 URL 的结尾
几个要记住的行为
| 写法 | 匹配 | 不匹配 |
|---|---|---|
| Disallow: /fish | /fish、/fish.html、/fishheads、/fish/salmon.htm | /Fish(大小写不同) |
| Disallow: /fish/ | /fish/ 目录下的全部内容 | /fish(没有斜杠的那个路径本身) |
| Disallow: /*.php$ | /file.php | /file.php?params(因为 $ 要求以 php 结尾) |
| Disallow: /fish* | 与 /fish 完全相同——末尾的通配符会被忽略 | — |
两个最容易错的点
- 末尾加星号是多余的。 `/fish*` 和 `/fish` 行为完全一样,因为路径匹配本来就是前缀匹配。很多人以为加了星号范围更大,其实没区别
- `$` 遇到参数就失效。 `/*.php$` 挡不住 `/file.php?id=1`。想连带参数一起挡,就不能用 `$`
几个实用写法
- 挡住所有带参数的 URL:`Disallow: /*?` ——但用之前先确认自己没有靠参数提供正常内容的页面
- 挡住某种文件类型:`Disallow: /*.pdf$`(注意这样挡住的是抓取,不是访问,也不是收录)
- 只挡一个具体参数:`Disallow: /*?sort=`
- 在挡住大范围之后放行一个子路径:先写 disallow,再写更长更具体的 allow
三、几起常见的屏蔽事故
下面这些都是行业里反复发生的情况。每一条都值得对着自己的站查一遍。
事故一:测试环境的规则跟着上线了
开发阶段为了不让爬虫抓测试站,写了 `User-agent: *` 加 `Disallow: /`。上线时忘了改,整站被屏蔽。
这是后果最严重的一种事故,而且极其常见。通常要到发现流量断崖式下跌才被查出来,而那时候已经过了几周。
预防办法:把 robots.txt 的内容检查列入上线检查清单的第一项,并在上线后立刻用工具验证一次。
事故二:屏蔽了样式和脚本目录
为了「节省抓取预算」把 `/assets/`、`/static/`、`/wp-content/` 之类的目录整个屏蔽掉。结果爬虫渲染页面时取不到样式和脚本,看到的是一个排版崩坏的页面。
这会直接影响对页面的理解和移动友好性判断。 正确做法是:允许抓取渲染页面所需的资源文件,不要屏蔽 CSS 和 JS。
事故三:用 robots.txt 去「隐藏」页面
想让某个页面不出现在搜索结果里,于是在 robots.txt 里 disallow 了它。结果这个页面的网址仍然出现在搜索结果中,只是没有摘要。
原因见下一节——这是对 robots.txt 作用的根本性误解。
事故四:大小写不匹配
网站的 URL 是 `/Products/`,robots.txt 里写的是 `Disallow: /products/`。规则完全不生效。
事故五:分组覆盖
文件里给 `User-agent: *` 写了十条细致规则,又单独写了一个 `User-agent: Googlebot` 分组、里面只有一行 `Allow: /`。结果对谷歌而言,那十条规则全部失效。
事故六:既 disallow 又想 noindex
在 robots.txt 里屏蔽了某个页面,同时在这个页面上加了 noindex 标签。结果这个页面反而更可能被索引——因为爬虫被 robots.txt 挡住了,根本读不到页面上的 noindex 标签。
这是个典型的自相矛盾配置,下一节详细说。
四、robots 与 noindex 的分工
这两件事解决的是完全不同的问题,混用是最常见的错误。
| robots.txt 的 Disallow | noindex 标签或响应头 | |
|---|---|---|
| 管什么 | 能不能抓取 | 能不能被索引 |
| 作用时机 | 爬虫请求之前 | 爬虫读取页面之后 |
| 能阻止收录吗 | 不能完全阻止 | 能 |
| 典型用途 | 避免抓取无价值的大量 URL、节省抓取资源 | 让页面不出现在搜索结果里 |
| 写在哪 | 网站根目录的 robots.txt | 页面的 meta 标签或 X-Robots-Tag 响应头 |
关键机制:disallow 不等于不收录
谷歌的文档说得很明确:谷歌无法索引被禁止抓取的页面的内容,但仍可能索引该网址并在搜索结果中显示,只是没有摘要。
这种情况通常发生在有外部链接指向该页面时——谷歌从链接知道了这个网址的存在,但因为不能抓取,只能收录一个没有内容的条目。
所以要让页面不出现在搜索结果里,正确的工具是 noindex 元标签或 X-Robots-Tag 响应头,而不是 robots.txt。
正确的配合方式
- 想让页面不出现在搜索结果里:页面上加 noindex,并且允许抓取(爬虫必须能读到这个页面才能看到 noindex)
- 想减少无意义 URL 的抓取消耗:用 robots.txt 的 disallow。适合参数排列组合产生的大量 URL、内部搜索结果页这类
- 两者都不要用在同一个 URL 上
- 需要彻底不被访问的内容(后台、客户文件):用服务器端的访问控制,不要依赖 robots.txt——它是一个公开可读的文件,任何人都能看到你列出的路径
最后这一条要强调:robots.txt 是公开的。把后台路径写在里面,等于把地址告诉了所有人。敏感路径应该用访问控制保护,而不是靠请求爬虫不要来。
五、修改后的验证方法
改完 robots.txt 一定要验证。五步:
- 直接访问确认文件内容。 在浏览器里打开网址加 /robots.txt,确认返回的是你刚改的版本、状态码是 200。缓存或 CDN 导致改动没生效的情况很常见
- 用搜索控制台的 robots.txt 报告检查。 确认谷歌读到的版本和你改的一致,并且解析没有报错
- 逐个测试关键页面。 把首页、主要产品页、主要文章页的网址分别测一遍,确认它们是允许抓取的。别只测被屏蔽的那些
- 测试资源文件。 把一个 CSS 文件和一个 JS 文件的网址也测一遍,确认没被误挡
- 改动后一周内盯一次覆盖率报告。 看有没有出现异常的「已被 robots.txt 屏蔽」条目数量上升
一个可以直接抄的基础模板
适用于大多数外贸内容站的最小写法:
- 对全部爬虫开放主要内容
- 屏蔽内部搜索结果页(这类页面数量可以无限膨胀且无独立价值)
- 屏蔽购物车、结算、账户等功能性路径
- 屏蔽明显无意义的参数组合(确认过不影响正常页面之后)
- 声明站点地图地址——这一行经常被漏,但它是让搜索引擎发现全站页面最省事的方式
不要在基础模板之外加你不确定作用的规则。robots.txt 的原则是宁少勿多——少写一条规则的代价通常只是多抓了几个无用页面,写错一条规则的代价可能是整站消失。
最后提醒一句:不同搜索引擎对 robots.txt 的解析细节并不完全一致。如果你同时在意谷歌和百度,建议改动之后在两边的站长工具里各验证一次,不要假设一套写法在两边行为相同。
常见问题
Q1. Disallow 了还会被收录吗?
会。谷歌的官方文档说得很明确:谷歌无法索引被禁止抓取的页面的内容,但仍可能索引该网址并在搜索结果中显示,只是没有摘要。这种情况通常发生在有外部链接指向该页面时——谷歌从链接知道了这个网址存在,但因为不能抓取,只能收录一个没有内容的条目。所以想让一个页面不出现在搜索结果里,正确的工具是页面上的 noindex 元标签或 X-Robots-Tag 响应头,而且必须允许抓取(爬虫要能读到这个页面才能看到 noindex)。最糟糕的配置是既在 robots.txt 里屏蔽、又在页面上加 noindex——爬虫被挡在门外,永远读不到那个 noindex,结果页面反而更可能以无摘要的形式被收录。另外提醒一点:robots.txt 是公开可读的文件,把后台路径写进去等于把地址告诉所有人,敏感内容应该用服务器端访问控制保护。
Q2. 要不要屏蔽参数 URL?
分情况,不能一概而论。该屏蔽的是那些由参数排列组合产生的、数量可以无限膨胀且没有独立价值的 URL,比如筛选器的各种组合、排序参数、会话标识、追踪参数。这类 URL 会消耗大量抓取资源却不带来任何收录价值,用 Disallow 挡掉是合理的。不该屏蔽的是靠参数提供正常内容的 URL——有些网站的分页、语言切换、甚至产品详情本身就是通过参数实现的,屏蔽了等于把正常页面挡在外面。所以动手之前必须先做一件事:导出站内实际存在的参数清单,逐个确认每个参数的作用。另外有一个更优的替代方案:如果参数产生的是同一内容的不同变体,优先用规范链接标签指向主版本,让搜索引擎自己合并,这比屏蔽更安全——屏蔽是一刀切,规范链接保留了内容被正确归并的可能。
Q3. 百度和谷歌的解析一样吗?
不完全一样,所以不要假设一套写法在两边行为相同。本文引用的规则(按路径长度判断最具体规则胜出、只使用最匹配的那一个用户代理分组、路径区分大小写、支持星号和美元符号两个通配符、500 KiB 处理上限)都来自谷歌的官方文档,是谷歌的行为规范。其他搜索引擎在通配符支持程度、分组匹配逻辑、以及对某些非标准字段的处理上都可能有差异。务实的做法是:第一,写法尽量保守,只用最基础的 User-agent、Disallow、Allow 和 Sitemap 字段,避免依赖某一家特有的扩展语法;第二,如果需要对不同搜索引擎做不同处理,分别写独立的用户代理分组,但要记住某些引擎只读最匹配的那一组,所以每组内的规则都要写全,不能指望通用分组补足;第三,改动之后在两边的站长工具里各验证一次。
参考来源
苏州维森特数字科技有限公司
谷歌官方授权一级代理商 · 一站式海外数字化营销解决方案
外贸独立站建站 · 谷歌SEO优化 · 谷歌广告推广 · Facebook推广